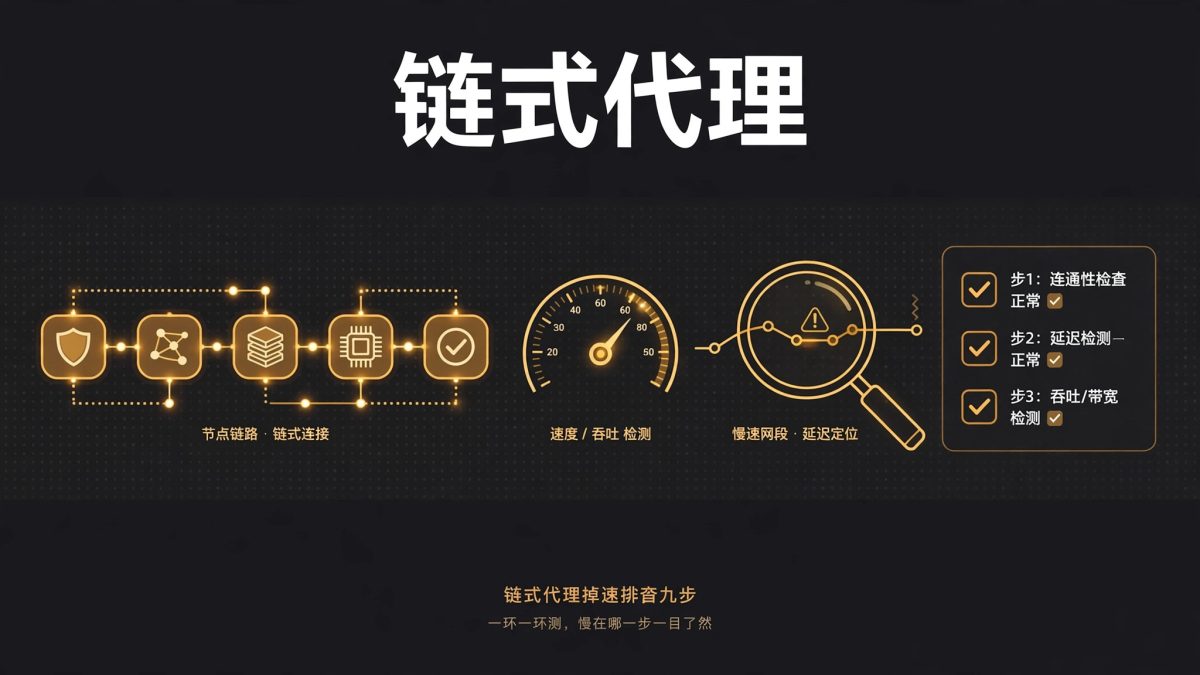

链式代理是把流量依次送过两台以上中转节点再抵达目标站点的接法:本地设备 → 节点 A → 节点 B → 目标站点。每多一跳,就多一次转发、一次握手和一段物理距离,速度天然比单节点低一截。但“比单节点慢一点”和“慢到没法用”是两回事——后者多半是链上某一环出了具体问题:某一跳丢包、DNS 绕路、MTU 卡住大包、握手反复重建,或只是晚高峰出口拥塞。
这篇只给一套能复现的排查流程:九步,从外到内,一次只动一个变量,每步都有命令和判定数值。走完九步,你能说出慢的是哪一跳、是什么原因,而不是凭感觉换一台节点再赌一次。
⚠️ 操作提醒:大陆用户切勿使用,请遵守当地法律法规,限海外用户使用。 以下步骤涉及自建节点与代理配置的操作,只面向合规使用场景。
九步总览
| 步骤 | 查什么 | 主要工具 | 判定要点 |
|---|---|---|---|
| 一 | 直连基线 | speedtest、curl | 先有基线,再谈掉速 |
| 二 | 逐跳延迟与丢包 | mtr、ping | 丢包从哪一跳开始、延续到终点 |
| 三 | 单线程真实带宽 | speedtest-cli | 多线程峰值会掩盖丢包 |
| 四 | 落地 IP 纯净度与归属 | curl、ipify | 出口 IP 与目标是否一致 |
| 五 | DNS 泄漏与解析路径 | dnsleaktest、browserleaks | 解析是否走了代理侧 |
| 六 | MTU 与分片黑洞 | ping -M do | 小页面能开、大文件卡死 |
| 七 | 协议与加密开销 | curl 计时 | 握手耗时占比是否异常 |
| 八 | 并发与限速 | curl、客户端统计 | 并发越高不等于越快 |
| 九 | 换节点与换链路对照 | 同一套命令 | 一次只换一个变量 |
步骤一:先测直连基线,没有基线就别谈掉速
断开代理,先把本地网络本身的水平量出来。同一目标、同一时段,直连和走代理各测三遍,取中位数对比。
# 直连测速(Ookla 官方命令行工具)
speedtest --accept-license --accept-gdpr

# 直连访问目标站点的分段耗时
curl -o /dev/null -s -w "建连:%{time_connect}s 首字节:%{time_starttransfer}s 总计:%{time_total}s\n" https://example.com
记下四个数:下载、上传、延迟、丢包(测速工具会直接给出前三项)。这四个数就是基线。后面每一步的结论都要拿来和基线比:走代理后延迟只多了几十毫秒、带宽损耗在 10%–20% 以内,属于多跳的正常开销(经验区间);带宽直接腰斩、延迟翻倍,才是真有问题。
步骤二:用 mtr 逐跳定位,丢包从哪一跳开始
mtr 把 ping 和 traceroute 合在一起,能看到去往目标的每一跳各自的延迟和丢包。这是整套流程里最关键的一步。
# 对目标域名做 100 次探测,出报告模式
mtr -rwbzc 100 example.com

# 怀疑某一跳时,对该跳 IP 单独持续 ping
ping -c 50 <该跳 IP>
读数规则只有两条,来自网络诊断的通用做法:
- 某一跳丢包、但终点丢包为 0%,不用管。 中间路由器经常限制对探测包的回复,转发真实流量却正常。
- 丢包从某一跳开始、并且一直延续到终点,就是真丢包。 这一跳就是瓶颈起点。同样,延迟在某一跳突然跳升、并且之后一直维持高位,慢的就是这一跳之后的链路。
判定数值(经验区间,标注为经验判断):持续丢包 3%–5% 以上,TCP 吞吐会明显下滑,网页时快时慢、连接偶发中断;单次探测偶尔丢一两个包,不必理会。同一条链路要在白天和晚高峰(20:00–23:00)各测一次,晚高峰国际出口常出现拥塞,白天正常、晚上丢包是常见现象。
步骤三:单线程测速,多线程峰值会骗人
测速工具默认开多条 TCP 连接并行跑,能把带宽数字叠得很好看,却会掩盖单条连接丢包、窗口崩掉的问题。日常浏览、看视频、跑 SSH,靠的都是单条连接的表现。
# Python 版 speedtest-cli,--single 为单线程模式
speedtest-cli --single

# 更贴近真实使用:单线程下载一个大文件,看实际速度
curl -o /dev/null -s -w "平均速度:%{speed_download} B/s 总计:%{time_total}s\n" https://speed.cloudflare.com/__down?bytes=100000000
判定标准:4K 60fps 视频大约需要 35Mbps 的稳定带宽(引自测速指南的常用口径),1080p 大约需要 5–8Mbps(经验区间)。单线程能稳定跑到目标带宽的 80% 以上,链路基本合格;单线程只有多线程峰值的零头、且波动极大,链路丢包或拥塞严重,回到步骤二看 mtr。
注意把测速服务器选在离落地节点近的位置:测速服务器远,测的是测速服务器到你的距离,不是链路本身的水平。
步骤四:查落地 IP 纯净度与归属
先确认流量到底从哪个 IP 出去、归属地写的是哪里。出口 IP 和目标站点期望的地区对不上,有些站点会反复验证、限速甚至直接拒绝,表现出来就是“慢”。
# 走代理查出口 IP(把代理地址换成自己的)
curl -x socks5h://127.0.0.1:1080 https://api.ipify.org
curl -x http://127.0.0.1:8080 https://api.ipify.org

# 直连查本地出口 IP,对照用
curl https://api.ipify.org
核对三项:出口 IP 的归属国家是否与节点标注一致;IP 属于数据中心号段还是住宅号段(目标站点对两类号段的待遇常有差别,属经验判断);同一节点多次查询,出口 IP 是否频繁跳变——频繁跳变会让需要保持会话的站点反复重建连接。
步骤五:查 DNS 泄漏,解析绕路也会拖慢首访
代理只转发数据流,域名解析可能还在本地进行。每次首次访问都要先等本地解析,再走代理建连,首字节时间会被拉长;解析结果还可能按本地位置返回,把流量导向更远的服务器。
# 让代理侧解析域名:SOCKS5 用 socks5h,HTTP 代理用 --proxy-dns 思路
curl -x socks5h://127.0.0.1:1080 -o /dev/null -s -w "解析:%{time_namelookup}s 建连:%{time_connect}s\n" https://example.com

# 对照:不带 h 的 socks5 会在本地解析
curl -x socks5://127.0.0.1:1080 -o /dev/null -s -w "解析:%{time_namelookup}s 建连:%{time_connect}s\n" https://example.com
浏览器侧的查法:挂上代理后打开 dnsleaktest.com,点 Extended Test(扩展测试发 36 次查询,比标准测试更彻底);再打开 browserleaks.com/dns 交叉验证。判定标准很直接:结果里出现的 DNS 服务器应当属于代理侧网络或你指定的公共解析服务;一旦出现本地宽带运营商的 DNS 服务器,就是泄漏。
修法按泄漏位置分:客户端解析走本地,改成 socks5h 或在客户端里开启远程解析;浏览器单独开了加密 DNS(DoH),按浏览器设置把它关掉或改成与代理一致的解析服务。改完重测一次,确认泄漏消失再往下走。
步骤六:查 MTU,小页面能开、大文件卡死就是它
典型故障:IP 查询页秒开、某个站点却永远打不开,连接建好了、握手也完成了,然后一直等到超时。原因是链路某一段能承载的最大包长(MTU)比系统默认的 1500 字节小,而中间设备又把“包太大”的 ICMP 提示丢掉了,系统永远不知道该把包改小——大包发出去就石沉大海。
# 不分片探测:1472 + 28 字节首部 = 1500,通不过就往下减
ping -M do -s 1472 example.com
ping -M do -s 1400 example.com
ping -M do -s 1300 example.com
如果 1472 不通、1400 通,路径 MTU 就在两者之间。修法是把隧道或网卡的 MTU 往下调一档:WireGuard 的默认值 1420 就是为这种场景留的余量;常见的可用值还有 1400、1380,从大到小试到稳定为止。改完后重新打开之前卡住的那个站点验证,大文件能正常下载才算修好。
这一步的特征非常典型:小请求全通、大请求全卡。符合这个特征就不用换节点,先查 MTU。
步骤七:查协议与加密开销,握手耗时占比说了算
每多一跳就多一次握手。HTTP 代理转发流程最短;HTTPS 代理要先建隧道再做加密握手;SOCKS5 居中;再叠加一层 TLS,首次连接的开销更大。协议选错,等于每建一个连接就多付一笔固定成本,短连接多的场景会被放大成整体掉速。
# 分段计时:解析、建连、TLS 握手、首字节、总计
curl -o /dev/null -s -w "解析:%{time_namelookup}s 建连:%{time_connect}s TLS握手:%{time_appconnect}s 首字节:%{time_starttransfer}s 总计:%{time_total}s\n" https://example.com

# 同一目标,换一种协议入口再测一次(示例为 HTTP 与 SOCKS5 对照)
curl -x http://127.0.0.1:8080 -o /dev/null -s -w "总计:%{time_total}s\n" https://example.com
curl -x socks5h://127.0.0.1:1080 -o /dev/null -s -w "总计:%{time_total}s\n" https://example.com
读数方法:总耗时里建连加 TLS 握手占大头,问题在握手环节——换更近的节点、或开启连接复用(同一连接上跑多个请求,握手只付一次);首字节占大头,目标站点本身响应慢,或请求触发了更严格的校验,先换目标站点对照。
链式代理里还有一层叠加开销:每一跳都可能单独做一次加密。两跳以上的链路,优先选轻量协议组合,别在每一跳都叠最重的加密。
步骤八:查并发与限速,并发越高不等于越快
并发开得太猛,本地带宽打满、代理端排队、目标站点开始丢请求,错误率上升,整体速度反而往下走。后台任务也在抢带宽:云同步、系统更新、视频通话,都会让测速结果失真。
# 先看本机谁在占带宽(Linux 示例)
ss -tulpn | head -20

# 压测对照:同一目标,先 10 并发,再 50 并发,各跑一轮看平均耗时与错误率
seq 1 10 | xargs -P 10 -I{} curl -o /dev/null -s -w "%{time_total}\n" https://example.com
调法(经验区间):并发从 50 起步,盯住平均耗时和错误率两个数,错误率超过 5% 就往回调;连接超时设 3 秒、读取超时设 10 秒,碰到慢节点快速失败、别干等 60 秒;能复用的连接一定复用,每次请求都重新握手等于把最贵的开销重复付一遍。
如果关掉全部后台同步和下载后速度立刻恢复,瓶颈在本地带宽分配,不在链路。
步骤九:换节点对照、换链路对照,一次只换一个变量
前八步都没查出问题,才轮到换节点。换的时候一次只换一个变量,否则永远不知道是哪一次改动起了作用。
对照 A——只换落地节点:保持第一跳不变,换一个同地区的落地节点,同一目标、同一时段,用步骤一的命令各测三遍。速度恢复,是落地节点的问题;没变化,问题不在落地。
对照 B——只换第一跳:保持落地节点不变,换一条第一跳链路再测。速度恢复,是第一跳线路的问题;没变化,问题在中间某跳或目标站点。
对照 C——换时段:同一套配置,在晚高峰(20:00–23:00)和凌晨各测一次。只在晚高峰慢,是出口拥塞或共享带宽被邻居占满,换一条非高峰拥塞的线路比换节点管用。
三组对照做完还慢,把步骤二的 mtr 结果、步骤三的单线程速度、步骤五的泄漏结果记在一张表里,再去找节点服务方沟通——有数据的问题单,比“很慢”三个字管用得多。
排查技巧
- 固定测试目标。 全程用同一个目标站点、同一个大文件链接测速,换目标等于换了考题。
- 一次只改一个变量。 节点、协议、MTU、并发,改一项测一项。
- 测三遍取中位数。 单次测速受瞬时抖动影响大,三遍里取中间值。
- 白天和晚高峰各测一次。 白天正常、晚上丢包,是拥塞不是配置错。
- 先查本地再查链路。 第一跳丢包、本机带宽占满,都是本地问题,别急着怪节点。
- 留一张排查记录表。 每步的命令、数值、结论记下来,下次掉速直接翻表对照。
想先把整套网络环境自查一遍,对照本站的 AI 账号环境自查清单;出境使用的 SIM 卡与网络搭配,参考本站 海外手机卡保号对比;数字身份与网络环境的搭配,见本站 帕劳数字居留申请攻略。
费用明细
| 工具/服务 | 费用 | 用途 |
|---|---|---|
| Ookla Speedtest CLI(官方命令行测速) | 免费 | 下载、上传、延迟、丢包 |
Python 版 speedtest-cli(--single 单线程) | 免费开源 | 单线程真实带宽 |
| mtr、ping、curl、dig、ss | 系统自带,免费 | 逐跳定位、分段计时、连接统计 |
| dnsleaktest.com(标准测试与扩展测试) | 免费 | DNS 泄漏检测 |
| browserleaks.com/dns | 免费 | DNS 与 WebRTC 泄漏交叉验证 |
| ipleak.net | 免费 | 出口 IP、DNS、WebRTC 一次看全 |
| VPS 节点与代理服务本身 | 按套餐收费,价格以服务商页面为准 | 链路硬件成本,不属于排查工具 |
排查本身不花钱:上面所有检测工具都是免费的。需要花钱的只有节点与带宽本身,排查的意义正在于先定位问题、再决定要不要为此花钱,而不是先花钱换节点再碰运气。
常见问题
问:挂了链式代理一定比直连慢吗?
多一跳确实多一次转发和握手,延迟会高几十毫秒。但如果代理侧的路由比直连路由更顺,个别场景下甚至可能更快。慢一点正常,慢一半以上才需要排查。
问:为什么测速很快,打开网页却很慢?
测速跑的是多线程大流量,网页打开靠的是单连接的首字节和 DNS 解析。按步骤三做单线程测速、按步骤五查 DNS 泄漏,两个数对上,答案就出来了。
问:延迟多少算正常?
没有放之四海皆准的数字,只看相对值:走代理后比直连基线多几十毫秒属于正常开销;同一地区内,相邻节点之间差一倍以上,就值得用 mtr 看看是哪一跳多出来的。
问:丢包多少算异常?
持续 3%–5% 以上的丢包会明显拖慢 TCP(经验区间),网页时快时慢、连接偶发中断;中间某一跳丢包、终点为 0%,不用管;丢包从某一跳开始并延续到终点,才是真问题。
问:九步走完还是慢,怎么办?
先确认三组对照的结果:换落地、换第一跳、换时段,分别是什么表现。带着 mtr 报告、单线程速度、DNS 泄漏结果去找节点服务方;换一家之前,先用同样的九步测一遍新链路,避免从一个坑跳进另一个坑。
本站部分内容由网友投稿,转载仅为学习交流之目的,不代表 518 PORT 立场;版权归原作者所有。如有侵权、虚假或违法内容,请联系我们删除;本站不承担因转载内容产生的任何责任。